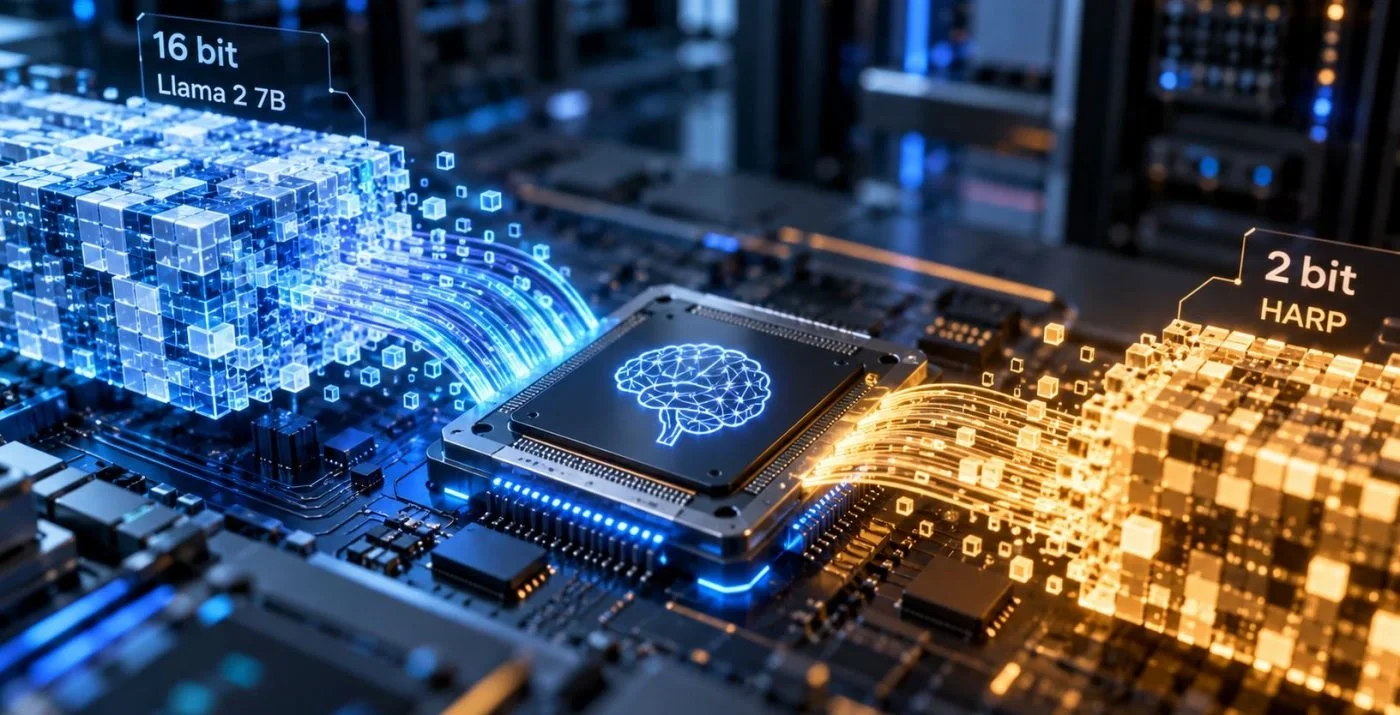
"BRAIn Lab" tədqiqat qrupunun üzvləri Artur Zaqitov, Gleb Molodsov və Aleksandr Beznosikov tərəfindən hazırlanan "HARP" alqoritmi süni intellekt sahəsində mühüm irəliləyiş hesab olunur. Bu texnologiya böyük dil modellərinin (LLM) yaddaş və hesablama resurslarına olan yüksək tələbat problemini həll etməyə yönəlib. Tədqiqat nəticəsində 2-bitlik "Llama 2" modeli saniyədə 128 token sürətlə işləyərək, orijinal 16-bitlik versiyanı (61 token/san) 2,1 dəfə üstələyib.
"HARP" texnologiyası necə işləyir?
Süni intellekt modellərinin sıxılması üçün istifadə olunan ənənəvi kvantlaşdırma üsulları çox vaxt məlumat itkisinə və modelin dəqiqliyinin azalmasına səbəb olur. "HARP" isə bu problemi neyroşəbəkənin müxtəlif qatları üçün fərdi şəkildə seçilən adaptiv riyazi çevrilmələr vasitəsilə aradan qaldırır. Bu yanaşmanın ən böyük üstünlüyü odur ki, orijinal modeli yenidən təlim etməyə ehtiyac qalmır.
Sınaqlar və nəticələr nəyi göstərir?
Texnologiyanın effektivliyi "Llama" ailəsinin 1-70 milyard parametrli modelləri və "Qwen3-8B" üzərində yoxlanılıb. "NVIDIA GeForce RTX 5080" qrafik kartında aparılan testlərdə 2-bitlik "Llama 2 7B" modeli "ARC-Challenge" testində 33% dəqiqlik göstərib. Müqayisə üçün qeyd edək ki, standart "QuIP#" metodu ilə bu göstərici 29,7%, 16-bitlik orijinal modeldə isə 40% təşkil edib.
Bu yenilik nə üçün vacibdir?
Tədqiqatçılar "HARP" alqoritminin mənbə kodunu və 2-bitlik "Llama 2 7B" versiyasını ictimaiyyətə açıq şəkildə paylaşıblar. Bu addım digər mütəxəssislərə texnologiyanı öz layihələrində tətbiq etməyə imkan verir. Gələcəkdə bu metodun tətbiqi məlumat mərkəzlərinin hesablama gücündən daha səmərəli istifadə olunmasına və böyük modellərin daha az yaddaşla işləməsinə şərait yaradacaq.