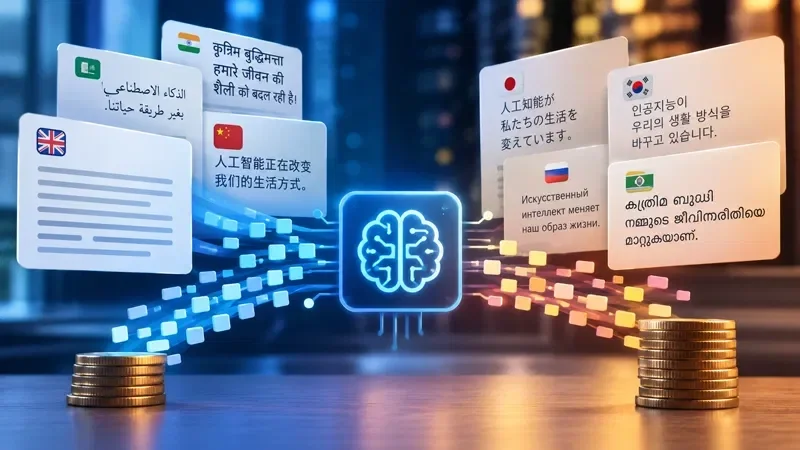
Süni intellekt (AI) sahəsində yeni bir rəqəmsal bərabərsizlik növü aşkar edilib. "CLEAR" (Coalition for Language Equality in AI Research) təşkilatının araşdırmasına görə, süni intellekt modellərinin sorğuları emal etmə dəyəri istifadə olunan dildən asılı olaraq kəskin şəkildə dəyişir. Bu fenomen mütəxəssislər tərəfindən "token vergisi" adlandırılır.
"Token vergisi" nədir və necə formalaşır?
Süni intellekt modelləri daxil olan məlumatları token adlanan kiçik fraqmentlərə bölərək emal edir. Kommersiya xidmətləri istifadə haqqını məhz bu tokenlərin sayına görə hesablayır. FLORES-200 korpusu üzərində aparılan təhlillər göstərib ki, ingilis dili ilə müqayisədə digər dillərdə eyni mənanı ifadə edən mətnlər daha çox tokenə bölünür. Bu fərq 200 dil arasında 17 dəfəyədək yüksələ bilər.
Bu problem istifadəçilərə necə təsir edir?
- İqtisadi yük: Qeyri-ingilis dilli istifadəçilər eyni nəticəni əldə etmək üçün daha çox ödəniş etmək məcburiyyətində qalırlar.
- Kontekst məhdudiyyəti: Daha çox token tələb edən dillər modelin yaddaşında daha az yer tutur, bu da istifadəçinin ötürə biləcəyi məlumat həcmini azaldır.
- Performans gecikməsi: Artıq token sayı hesablamaların çətinləşməsinə və cavab müddətinin uzanmasına səbəb olur.
Tədqiqatçılar qeyd edirlər ki, xüsusilə birman, tibet, khmer və laos kimi dillər bu problemdən daha çox əziyyət çəkir. Problemin həlli üçün təkcə təlim məlumatlarının həcmini artırmaq kifayət deyil; həmçinin müxtəlif əlifba və yazı sistemləri üçün xüsusi tokenizatorların hazırlanması və təkmilləşdirilməsi tələb olunur.